Cuando una caché hace más que solo caché
La mayoría de la gente piensa en una caché como un simple acelerador de rendimiento: almacena un resultado, lo reutiliza más tarde y listo.
Pero en sistemas con alta concurrencia, una caché puede desempeñar un papel más importante. Puede convertirse en un mecanismo de coordinación que protege al resto del sistema de duplicar trabajo innecesario.
Esa es la idea detrás de cpp-cache, basada en un diseño creado en C++ en 1998 y que funciona en producción desde hace más de cinco años en su versión en Go. Dónde se usa ese protocolo y qué se midió está en la ficha de experiencia Caché y arquitectura para una API de apuestas deportivas.
El problema: demasiados hilos, el mismo fallo (miss)
Imagina que se solicita una clave popular en el momento exacto en que aún no está en la caché.
Si diez, cincuenta o cien hilos se encuentran con ese mismo fallo aproximadamente al mismo tiempo, una implementación ingenua dispara el mismo cálculo costoso una y otra vez. En lugar de reducir la carga, la caché la amplifica. Se consume más CPU, se genera más presión en el backend y la latencia se vuelve más difícil de controlar.
Este es el clásico problema del thundering herd (manada atronadora).
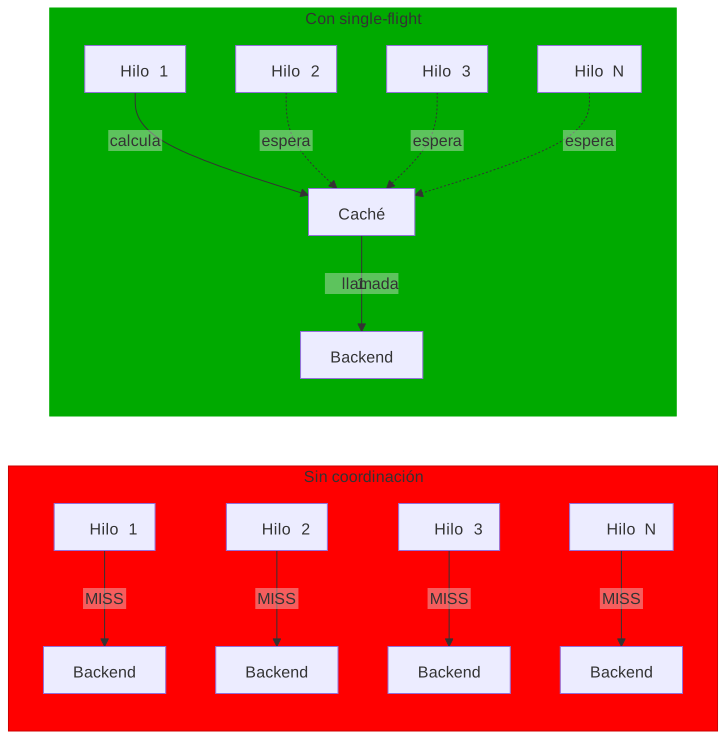
A la izquierda, cada hilo golpea el backend de forma independiente. A la derecha, un hilo calcula mientras el resto espera — el backend ve una sola llamada.
Aquí está la diferencia en la práctica:
// Sin coordinación: cada hilo calcula de forma independiente
auto val = expensive_backend_call(key);  // x100 hilos = x100 llamadas

// Con cpp-cache: un hilo calcula, el resto espera y comparte
auto result = cache.get_or_compute(key);
// Solo una llamada al backend. Los 100 hilos obtienen el mismo resultado.

if (result.is_positive())
    use(*result.value());
Una buena caché concurrente no debería limitarse a recordar valores. También debería evitar que el sistema se colapse cuando falta el valor.
La solución: un cálculo por clave
La propiedad más importante del diseño es sencilla:
Si varios hilos solicitan la misma clave que falta, solo uno de ellos realiza el cálculo. Los demás esperan y reutilizan el resultado.
Esto se conoce como comportamiento single-flight.
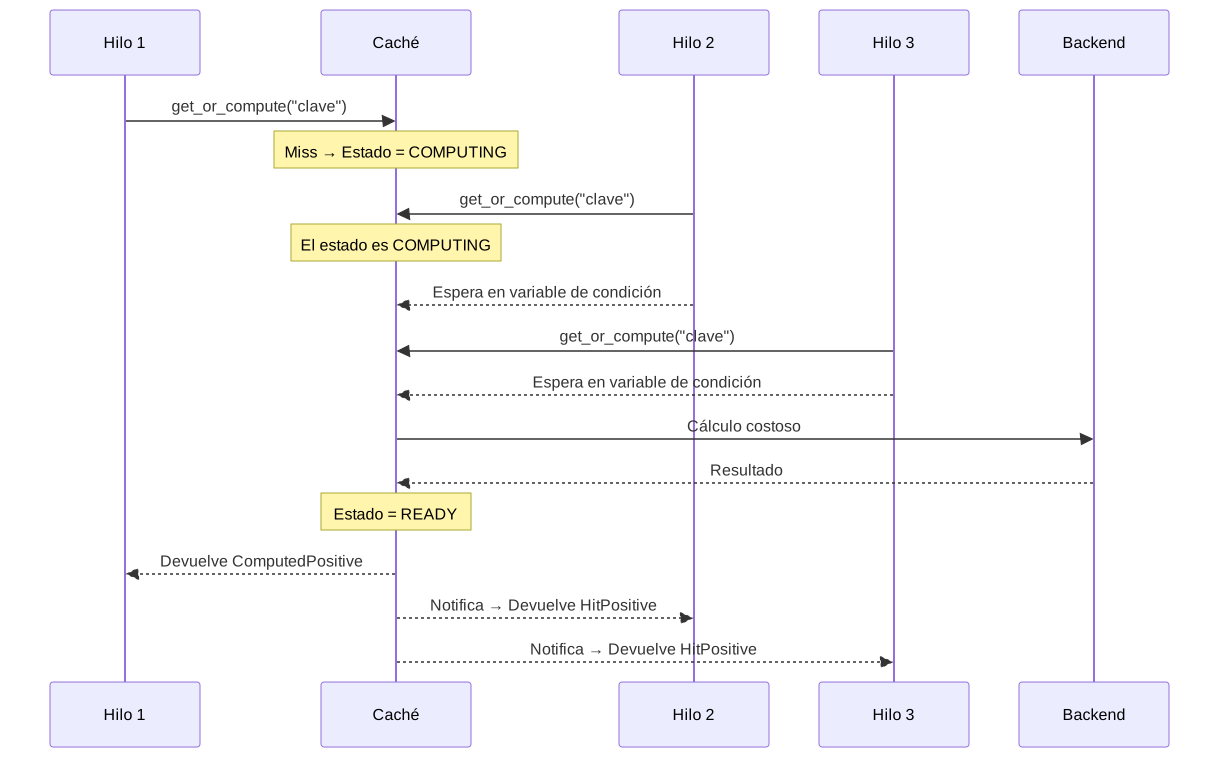
Lo mejor de este enfoque es que no sacrifica la concurrencia general. Los hilos que solicitan claves diferentes pueden seguir avanzando de forma independiente. La coordinación ocurre donde debe: en la clave en disputa, no en toda la caché.
El bloqueo global que protege la tabla hash y la lista LRU se mantiene solo para operaciones estructurales de nivel de microsegundos: búsqueda, inserción, reordenación. Todas las peticiones lo toman brevemente, incluidos los aciertos (búsqueda y paso de la entrada al frente de la LRU), pero nunca se mantiene mientras el “solver” (el calculador) se ejecuta. Eso significa que el trabajo costoso ocurre sin bloqueos, y diferentes claves se pueden calcular realmente en paralelo.


La clave fundamental: la Fase 2 (donde ocurre el trabajo real) mantiene cero bloqueos. Por eso se pueden resolver múltiples claves de forma concurrente aunque haya un único mutex global.
Diseñado también para fallos del mundo real
Otro aspecto notable de la caché es que trata los fallos como resultados significativos.
Tanto los resultados exitosos como los fallidos pueden almacenarse en la caché, cada uno con su propio TTL.
¿Por qué es importante? Considera un escenario concreto: tu backend devuelve un 404 para un recurso que no existe. Sin caché negativa, cada una de las peticiones para ese recurso vuelve a intentar consultar el backend. Bajo un tráfico alto, una clave inexistente puede generar tanta carga como una popular — quizás más, porque nunca hay un resultado en caché que absorba las peticiones.
Con la caché negativa, el primer fallo llama al “solver”, obtiene un error y almacena ese error durante 30 segundos (o el TTL negativo que se haya definido). Durante los siguientes 30 segundos, todas las peticiones posteriores ven el fallo almacenado inmediatamente. El backend queda protegido.
Es una característica pequeña con una recompensa muy práctica, especialmente en sistemas donde el conjunto de claves “ausentes conocidas” es grande o donde un fallo del backend es temporal y reintentarlo cientos de veces por segundo no sirve de nada.
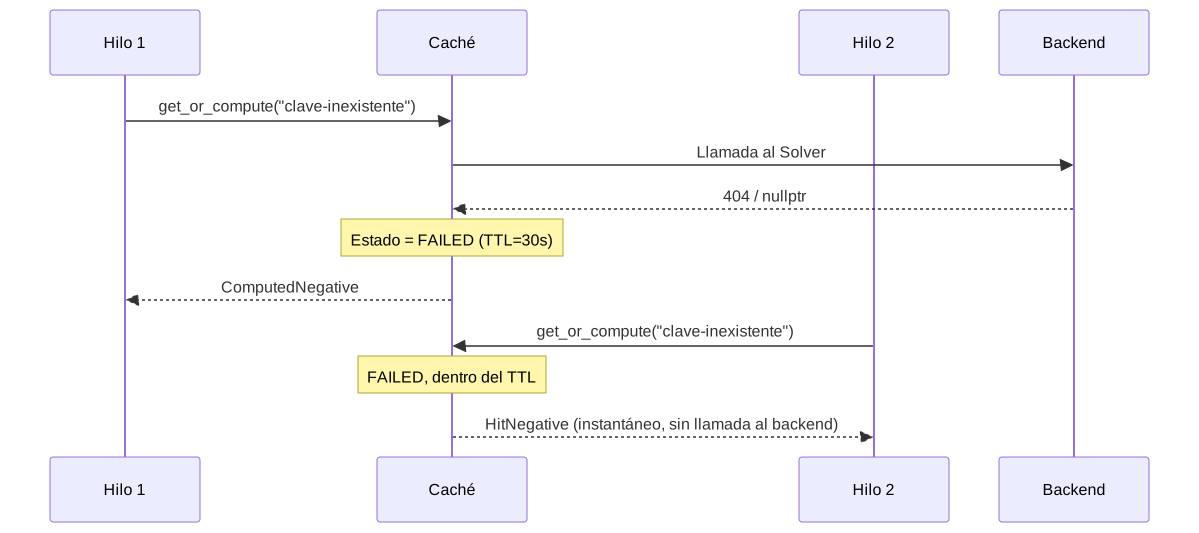
Se llama al backend una vez. Durante los siguientes 30 segundos, cada petición para esa clave obtiene un fallo inmediato en caché — sin llamadas redundantes.
Tiempos de vida más seguros bajo concurrencia
El diseño separa la validez lógica de la vida útil física.
Los valores almacenados en caché se exponen a través de shared_ptr, lo que significa que un valor puede ser expulsado o invalidado por la caché sin volverse inseguro inmediatamente para el código que todavía lo está utilizando.
¿Por qué es importante concretamente? Sin esta separación, un hilo que lee un valor en caché podría colapsar si otro hilo lo expulsa en el momento equivocado. Ese es un error de “uso después de liberación” (use-after-free), una de las clases más peligrosas de errores de memoria en C++, y que solo se manifestaría bajo condiciones de temporización específicas en producción.
La caché también mantiene un recuento de referencias atómico interno en cada entrada. Una entrada no puede ser expulsada si algún hilo está trabajando activamente con ella. Este invariante está codificado en el modelo formal (más sobre esto abajo).
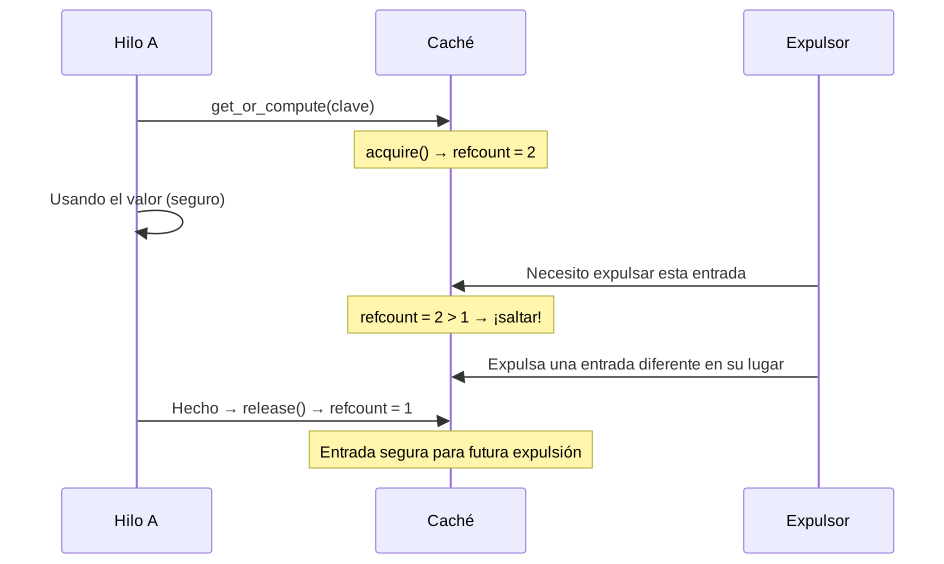
El recuento de referencias actúa como un escudo: mientras cualquier hilo esté usando activamente una entrada, el expulsor la ignora. Esa es precisamente una de las propiedades que el modelo formal comprueba para el protocolo.
Una caché con estados explícitos
Internamente, las entradas pasan por estados explícitos: calculando, listo, fallido e invalidado.
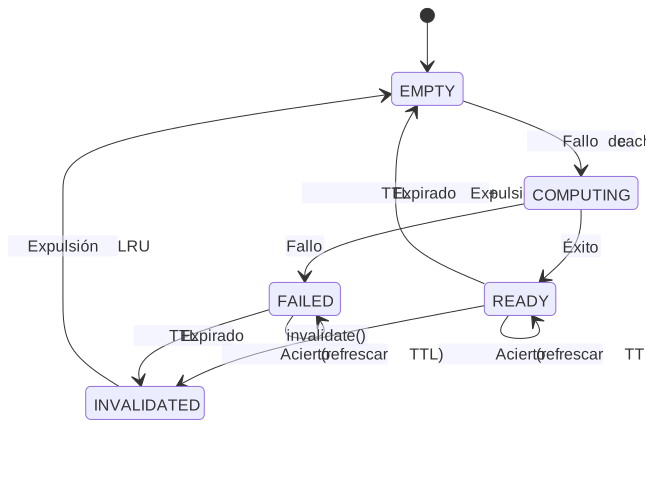
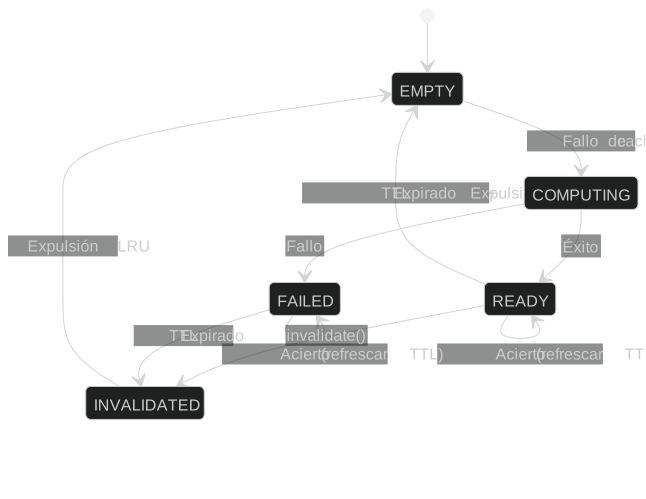
Observa los bucles sobre Ready y Failed: cada acierto de caché refresca el TTL, implementando una ventana deslizante que mantiene vivas las entradas accedidas con frecuencia.
Es una decisión de diseño con una consecuencia que conviene tener presente: el TTL deslizante limita la inactividad, no la antigüedad del dato. Una clave que se consulta más a menudo que su TTL no expira nunca, y lo mismo ocurre con un resultado negativo: si un recurso que no existía aparece en el origen, una clave negativa muy consultada seguirá devolviendo “no existe”. Para datos que cambian en el origen, la frescura se controla llamando a invalidate() cuando el origen notifica un cambio. Ten en cuenta que si el origen cambia mientras una clave está en estado de cálculo (Computing), invalidate() devolverá falso; se debe invalidar la clave nuevamente una vez finalizado el cálculo para evitar que se siga sirviendo un resultado obsoleto. Para datos inmutables o de referencia, el TTL deslizante es exactamente lo que se quiere.
Tener los estados explícitos importa.
Hace que la implementación sea más disciplinada, las reglas de concurrencia más fáciles de razonar y el comportamiento previsto más fácil de verificar.
Verificación formal del protocolo
Lo que hace que este proyecto sea especialmente interesante para mí es que no se detiene en las pruebas.
El repositorio incluye un modelo formal Promela/SPIN del protocolo de concurrencia (formal/cache_model.pml), con aserciones de seguridad y diez propiedades LTL de vitalidad (liveness), entre ellas la terminación, la ausencia de inanición y la garantía de que cada clave solicitada se calcula eventualmente.
Conviene precisar qué demuestra y qué no. El modelo está acotado (capacidad de 2 entradas, 3 claves y 6 hilos) y representa el comportamiento del protocolo, no una traducción línea por línea del código C++; la expiración se modela de forma abstracta. La verificación establece que el protocolo cumple esas propiedades en ese espacio de estados. No cubre el modelo de memoria de C++, el compilador ni las excepciones, y la correspondencia entre modelo y código se mantiene por revisión, con pruebas de concurrencia y Valgrind como complemento.
El valor práctico del modelo está en contrastarlo con la implementación: cada guarda del modelo, como comprobar el recuento de referencias antes de expulsar una entrada, debe existir también en el código, y esa revisión cruzada forma parte del trabajo. Los resultados de una corrida de SPIN sobre el modelo actual (versión del verificador, commit, espacio de estados explorado y propiedades comprobadas) están publicados con su salida completa y explicados en Verificación formal de una caché C++ con SPIN/Promela, que detalla el alcance del modelo y presenta las cifras de la corrida.
Una mirada honesta a los compromisos (tradeoffs)
Ningún diseño está exento de compromisos, y reconocerlos es importante.
- Mutex global: El bloqueo único que protege la estructura funciona bien cuando el calculador es el verdadero cuello de botella (que suele serlo), pero podría convertirse en un punto de contención bajo miles de hilos con tasas de fallos muy altas. Se planea la fragmentación (sharding) en N sub-caches.
- Dependencia de Aleph-w: La caché utiliza las estructuras de datos intrusivas de Aleph-w para mejorar el rendimiento, pero esto hace que la integración sea más difícil que la de una biblioteca sin dependencias. Se está considerando un modo autónomo.
- Benchmarks: El protocolo se validó en 2023 hasta 100K peticiones/segundo en entornos controlados con su implementación en Go (
gateway_cache). En 2026 publicamos mediciones nuevas decpp-cachey degateway_cachecon el mismo protocolo, en una máquina declarada y con los datos crudos: Benchmarks. Son cifras de biblioteca, no de la arquitectura completa ni de producción.
Estas son limitaciones reales. No socavan el diseño central, pero condicionan su adopción hoy en día.
Por qué vale la pena preocuparse por esto
La infraestructura como esta rara vez atrae la misma atención que las funciones orientadas al cliente, pero tiene un apalancamiento enorme.
Una mejor caché concurrente puede significar:
- menos llamadas duplicadas al backend,
- menos desperdicio bajo tráfico por ráfagas,
- latencia más predecible,
- comportamiento de memoria más seguro,
- y mayor confianza en la corrección — no solo por las pruebas, sino por la verificación formal del protocolo.
Ese es el tipo de mejora de ingeniería que ayuda silenciosamente a todo lo que hay encima.
Qué sigue
El proyecto está disponible de forma abierta en lrleon/cpp-cache. Si quieres probarlo, las instrucciones de construcción muestran cómo compilar y ejecutar las pruebas en menos de cinco minutos.
Los próximos pasos planeados incluyen:
- Benchmarks con recuento de hilos, espacio de claves y tasa de fallos configurables.
- Fragmentación (Sharding) para escalabilidad lineal con los núcleos.
- Una variante
try_find()que devuelva inmediatamente si se está calculando una entrada. - Opción de compilación autónoma sin Aleph-w.
Las contribuciones, los comentarios y las críticas constructivas son bienvenidos.
Reflexión final
Lo que más me gusta de esta versión de cpp-cache es que refleja una idea madura de la ingeniería de rendimiento.
No se trata solo de almacenar resultados más rápido. Se trata de controlar la contención de forma inteligente, proteger al sistema del comportamiento de manada y tratar la corrección como parte del trabajo de rendimiento, no como algo secundario.
Tener un modelo formal del protocolo, y contrastarlo con el código, es el tipo de inversión en rigor que vale la pena. No todos los proyectos necesitan un modelo Promela — pero cuando estás construyendo infraestructura concurrente de la que dependen otros sistemas, el coste de un error sutil en producción supera con creces el coste de construir un modelo.
Ese es exactamente el tipo de inversión en infraestructura que da sus frutos con el tiempo.
Si tu sistema depende de una infraestructura concurrente parecida, así trabajamos: consultoría técnica en rendimiento y arquitectura y desarrollo de backends y APIs de alto rendimiento.